Коротко
- Query fan-out это прием, при котором система разбивает вопрос на подтемы и ищет по каждой отдельно.
- Google подтверждает fan-out для AI Overviews и AI Mode словом "может", без списка уточнений для владельца сайта.
- У сервисов, обещающих точные скрытые запросы ИИ, нужно проверять происхождение данных: наблюдаемые действия API и реконструкция скрытого поиска не одно и то же.
- Рабочий инструмент это карта решений покупателя с фактом и одним URL-владельцем для каждого решения.
- Страницы под каждый синоним и город попадают под правила Google о дорвеях и масштабированном контенте.
От вопроса до уточнений
Человек в поиске пишет три слова. В чате с ИИ он описывает ситуацию целиком, со всеми условиями. Чтобы ответить на такой вопрос, системе мало одного поиска. Она разбивает вопрос на части и ищет по каждой.
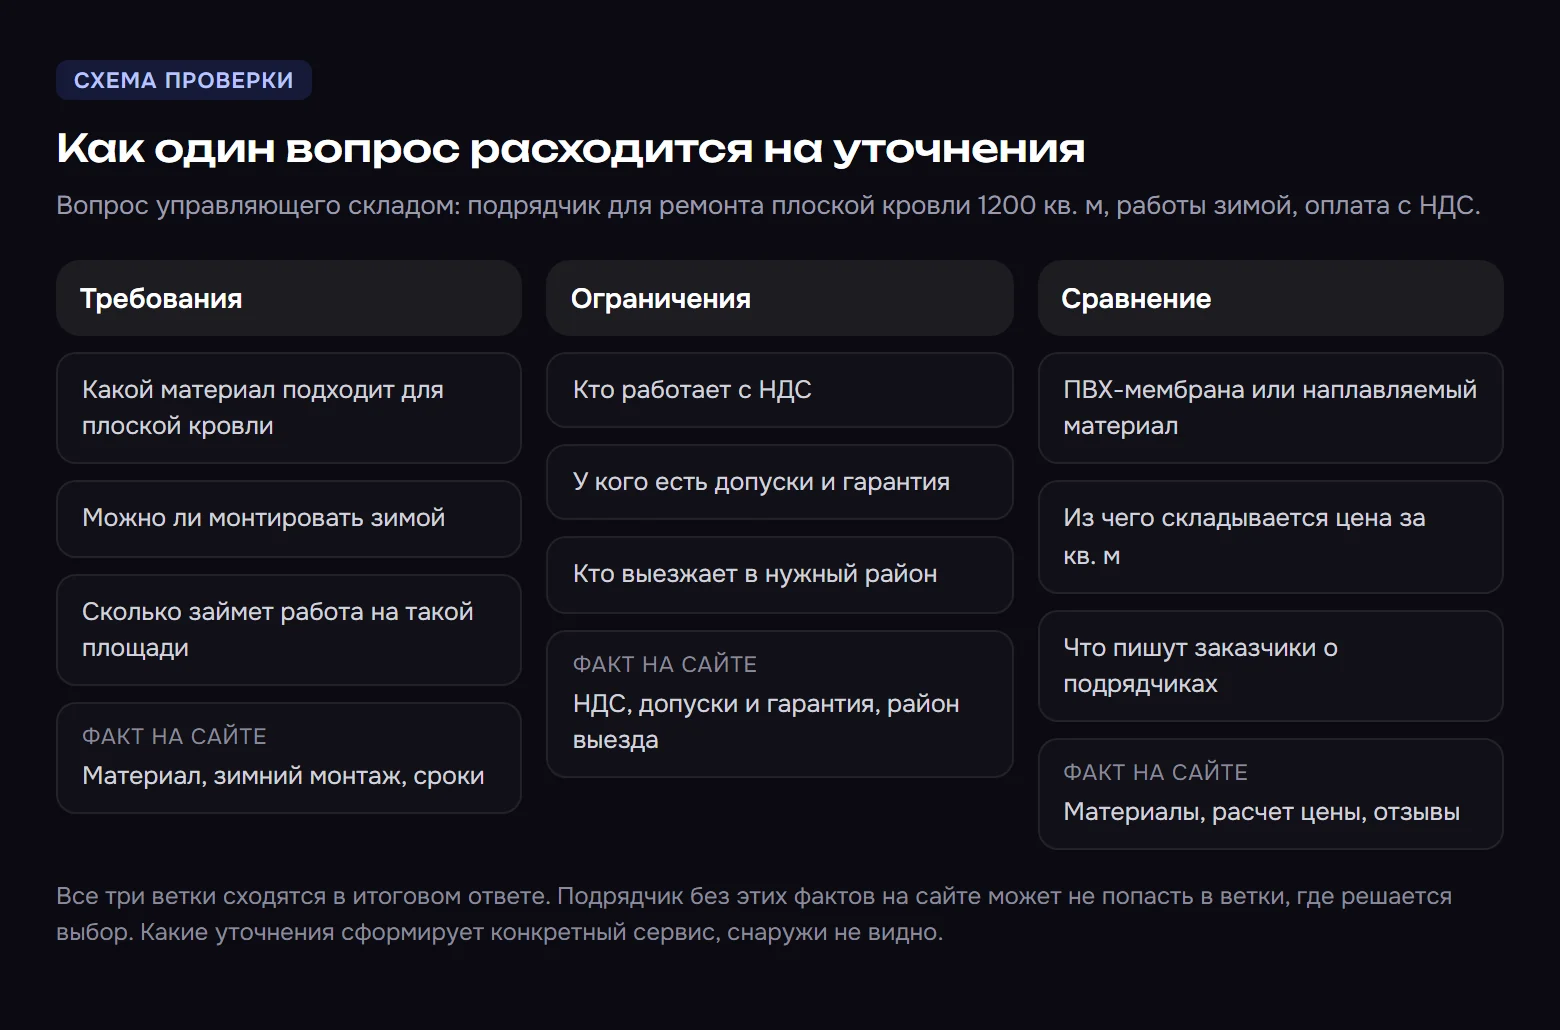
Текстовая версия схемы
- Требования
- Какой материал подходит для плоской кровли
- Можно ли монтировать зимой
- Сколько займет работа на такой площади
- Факт на сайте: Материал, зимний монтаж, сроки
- Ограничения
- Кто работает с НДС
- У кого есть допуски и гарантия
- Кто выезжает в нужный район
- Факт на сайте: НДС, допуски и гарантия, район выезда
- Сравнение
- ПВХ-мембрана или наплавляемый материал
- Из чего складывается цена за кв. м
- Что пишут заказчики о подрядчиках
- Факт на сайте: Материалы, расчет цены, отзывы
Итоговый ответ собирается из найденного по всем веткам. Подрядчик, у которого на сайте нет ни слова о зимнем монтаже и работе с НДС, может просто не попасть в те ветки, где решается выбор.
Похожее делает и ChatGPT. В справке OpenAI о поиске сказано, что ChatGPT обычно переписывает вопрос в один или несколько целевых запросов к поисковым партнерам, после первых результатов может отправить более точные, а включенная память тоже влияет на формулировку. Как готовить к этому сайт, мы разобрали в статье как попасть в рекомендации ChatGPT.
Что подтверждает Google
Термин query fan-out Google использует официально. В руководстве для владельцев сайтов сказано, что AI Overviews и AI Mode могут применять этот прием, то есть отправлять несколько связанных поисков по подтемам и разным источникам данных, чтобы собрать ответ. Там же отмечено, что AI Mode и AI Overviews могут использовать разные модели и техники, поэтому набор ответов и ссылок у них различается. AI Overviews показываются только тогда, когда системы Google считают их полезным дополнением к обычной выдаче, и часто не появляются вовсе.
В анонсе AI Mode в блоге Google механизм описан подробнее. AI Mode разбивает вопрос на подтемы и одновременно отправляет множество запросов от имени пользователя. Режим глубокого исследования, по словам Google, может выполнить сотни поисков.
Чего Google не подтверждает
Главное слово в документации "может". Google не пишет, что fan-out срабатывает на каждый вопрос, не раскрывает число и формулировки уточнений и не дает владельцу сайта отчета о них. У сервиса, который показывает "точные скрытые запросы ИИ", запросите метод получения данных. Отдельные действия API могут быть наблюдаемыми, а скрытые поиски интерфейса могут быть лишь реконструкцией; универсального вывода без проверки нет.
Агентство iPullRank в своей методике Relevance Engineering исходит из того, что поисковые системы расширяют запросы по смыслу и опираются на тематические кластеры, а ИИ ищет конкретные фрагменты текста. Это рабочая модель агентства, а не описание алгоритмов. Какие страницы и фрагменты попадают в источники ответа и что из этого можно доказать, разобрано в материале о том, как AI-поиск выбирает источники.
Как строить карту подтем
Карта подтем отвечает на вопрос, какие решения принимает покупатель и где на сайте лежат факты для каждого решения. Строится она в четыре шага.
- Собрать реальные вопросы. Источники это звонки и переписка отдела продаж, вопросы из тендеров, возражения на встречах, отзывы клиентов.
- Сгруппировать их по решениям. Подходит ли технология, укладываемся ли в сроки, можно ли доверять подрядчику, сколько это стоит.
- Для каждого решения записать факт, без которого его не принять. Цифра, условие, документ, пример работы.
- Назначить URL-владельца. Это основная страница для самостоятельного решения покупателя. Общие факты, например контакты и действующие условия, могут корректно повторяться на других страницах.
| Вопрос покупателя | Уточнение | Нужный факт | URL-владелец |
|---|---|---|---|
| Кто отремонтирует кровлю склада | Материал для плоской кровли | Какие материалы компания монтирует и для каких объектов | Страница услуги ремонта плоской кровли |
| Можно ли делать работы зимой | Зимний монтаж мембраны | Температурные ограничения, как организована работа | Раздел на той же странице услуги |
| Кто работает с НДС и допусками | Условия договора | Форма оплаты, допуски, гарантийный срок | Страница о компании и документах |
| Что выбрать, ПВХ или наплавляемый материал | Сравнение материалов | Срок службы, условия монтажа, примерная стоимость | Статья-сравнение в блоге |
| Сколько стоит ремонт 1200 квадратных метров | Цена за квадратный метр | Из чего складывается цена, вилка или порядок расчета | Страница услуги, блок цен |
Если для самостоятельного вопроса нет основной страницы, сначала ищут страницу, куда он логично ложится разделом. Новый URL создают, когда у вопроса отдельное решение и отдельный читатель. Сравнение материалов полезно и тому, кто подрядчика еще не выбирает.
Один основной URL назначают самостоятельному интенту, а не каждому повторяющемуся факту. Название, телефон и действующие условия могут присутствовать на нескольких страницах. Проблема возникает при противоречиях или когда несколько почти одинаковых страниц претендуют на одно и то же решение покупателя.
Почему не нужна страница на каждый вариант
Fan-out часто понимают так. Раз ИИ задает много уточнений, надо выпустить страницу под каждое. Ремонт кровли зимой, ремонт кровли с НДС, ремонт кровли в Химках, в Мытищах, в Подольске, и так сотня адресов.
Результат обычно один. Десятки страниц с одним и тем же текстом, где меняется город или пара слов. В правилах Google о спаме такие схемы описаны прямо. Страницы под похожие запросы и отдельные регионы, которые ведут посетителя к одной и той же цели, относятся к дорвеям. Массовое создание страниц ради позиций без пользы для читателя относится к злоупотреблению масштабированным контентом, и неважно, писал их человек или нейросеть.
Есть и довод из исследований. Semrush вместе с Кевином Индигом изучили 1094 категории в США в ChatGPT с января по июнь 2026 года, по пять типовых вопросов покупателя в каждой. Авторы называют брендом-владельцем темы того, кто появляется в ответах минимум на четыре вопроса из пяти и опережает ближайшего конкурента на 5 процентных пунктов. Явный владелец нашелся только у 15,2% категорий. Это синтетическая панель с собственным определением, но вывод понятен. Выигрыш одного вопроса не дает устойчивого присутствия в теме, а копии страницы под синонимы ничего не добавляют к ответам на соседние вопросы.
Отдельная страница под город оправдана, если в нем другая услуга, свой офис, свои цены или условия выезда. Если отличается только название, город указывают в зоне обслуживания на основной странице.
Как применить в работе
На практике работа с fan-out сводится к проверке, закрывает ли сайт все решения покупателя. Порядок такой.
- Карта подтем собрана. По каждой услуге есть 10-20 реальных вопросов, сгруппированных по решениям, и у каждого решения есть URL-владелец.
- Факты на месте. Каждый нужный факт написан текстом на странице-владельце, рядом с формулировкой вопроса, а не в PDF или на картинке.
- Нет дублей. Два URL не отвечают на один и тот же вопрос одинаковым текстом.
- Ответ полезен. Сотрудник, который не писал страницу, находит на ней ответ на каждый вопрос из карты меньше чем за минуту.
- Наблюдение без выводов о причинах. Вопросы из карты периодически задают в нужных ИИ-сервисах и записывают дату, режим и источники. Это показывает картину ответов, но не раскрывает скрытые запросы.
Обещать, что после правок сайт попадет в нужные ветки, честно нельзя. Можно сделать так, чтобы ответ на каждое уточнение у вас был и находился.
Собрать вопросы от продаж и проверить, отвечают ли на них страницы, владелец может сам. Когда карта выходит за пару десятков страниц, нужно разобраться с дублями и URL-владельцами или связать карту с реальными источниками ответов, это задача для SEO и GEO-специалиста, например в рамках услуги продвижение бизнеса в ответах ИИ.
Частые вопросы
Google не описывает такого отчета. Показы сайта в AI Overviews и AI Mode входят в общий отчет об эффективности в Search Console, но список уточнений к конкретному ответу там не раскрывается.
Нет. Семантическое ядро собирают по запросам, которые люди вводят в поиск. Карта подтем строится по решениям покупателя и фактам, которые для них нужны, и может включать вопросы, которых нет в статистике поиска.
Не обязательно. Достаточно, чтобы каждый факт был изложен ясно и рядом с понятным подзаголовком. Блок FAQ уместен там, где вопросы действительно задают покупатели.
В источниках этой статьи такой механизм описан только для Google и поиска ChatGPT. Переносить выводы на Алису без документации Яндекса нельзя.
Источники
- Google Search Central. AI features and your website
- Google. AI Mode in Google Search: Updates from Google I/O 2025
- OpenAI Help Center. Searching the web with ChatGPT
- Google Search Central. Spam policies for Google web search
- Semrush. AI visibility is a topic-level game: A study of 50,000 brands in ChatGPT
- iPullRank. An Introduction to the Relevance Engineering Framework
 Александр Кабанец