Коротко
- За показ в поиске ChatGPT отвечает OAI-SearchBot, за сбор данных для обучения отвечает GPTBot.
- Запрет GPTBot не убирает сайт из поиска ChatGPT, это отдельная настройка.
- Разрешения в robots.txt недостаточно, если WAF или CDN отдают роботу 403 или проверку браузера.
- Подлинность визита подтверждает IP из официального списка OpenAI, а не строка User-Agent.
- Закрытые разделы защищают авторизацией, robots.txt для этого не годится.
Какое назначение у каждого бота
OpenAI описывает своих роботов в документации для владельцев сайтов, и у каждого своя задача. Настройки для них независимы. Можно разрешить одного робота и запретить другого, противоречия здесь нет.
OAI-SearchBot
Этот робот работает на поиск ChatGPT. По документации OpenAI, сайты, закрытые для OAI-SearchBot, не показываются в поисковых ответах ChatGPT, хотя могут остаться в виде навигационных ссылок. OpenAI советует разрешить его в robots.txt и пропускать запросы с опубликованных адресов. После правки robots.txt поиску нужно около суток, чтобы учесть новое правило.
GPTBot
GPTBot собирает материалы, которые могут попасть в обучение базовых генеративных моделей OpenAI. Запрет GPTBot сообщает, что тексты сайта не должны использоваться для обучения. На поиск в ChatGPT этот запрет не влияет, за поиск отвечает другой робот. Если разрешены оба, OpenAI может взять результат одного обхода для обеих задач, чтобы не нагружать сервер дважды.
ChatGPT-User
Этот агент открывает страницу, когда человек сам задал вопрос в ChatGPT или в пользовательском GPT. Сайты он автоматически не обходит. OpenAI прямо пишет, что правила robots.txt к таким запросам могут не применяться, а для управления показом в поиске нужен OAI-SearchBot.
Есть еще OAI-AdsBot. Он проверяет посадочные страницы, которые отправили как рекламу в ChatGPT, и на другие страницы не ходит.
| Бот | Назначение | Публичный доступ | Проверка | Что нельзя заключать |
|---|---|---|---|---|
| OAI-SearchBot | Показ сайта в поиске ChatGPT | Открыть публичные разделы | robots.txt, коды ответа, IP из searchbot.json | Что открытый доступ приведет к рекомендации |
| GPTBot | Сбор материалов для обучения моделей | По решению владельца | robots.txt, IP из gptbot.json | Что запрет GPTBot убирает сайт из поиска ChatGPT |
| ChatGPT-User | Открытие страницы по запросу пользователя | Публичные страницы без входа | Логи, IP из chatgpt-user.json | Что robots.txt надежно останавливает такие визиты |
| OAI-AdsBot | Проверка рекламных посадочных страниц | Только страницы объявлений | Логи после запуска рекламы | Что визит связан с органическим поиском |
Составлено по документации OpenAI о роботах, проверено 22.10.2026.
Правила одной платформы нельзя переносить на другую. В руководстве Google про AI-функции сказано, что показ в AI Overviews и AI Mode регулируется теми же правилами для Googlebot, что и обычный поиск, а токен Google-Extended касается обучения и некоторых других систем Google. Если нужна общая последовательность подготовки сайта, она разобрана в материале как попасть в рекомендации ChatGPT.
Что проверять кроме robots.txt
Строка Allow в robots.txt не доказывает, что робот получил страницу. Между правилом и ответом сервера стоят хостинг, CDN, защита от ботов и настройки самой CMS. Google в руководстве про AI-функции советует проверять разрешение на обход и в robots.txt, и в инфраструктуре CDN или хостинга. Для роботов OpenAI логика та же.
Коды ответа
Публичная страница должна отдавать код 200 и HTML с содержанием. Ответы 403 и 429 на запросы роботов чаще всего значат, что их остановил фильтр или лимит частоты. Для страниц за авторизацией Google рекомендует честный код 401. Хуже всего заглушка с кодом 200, когда вместо статьи робот получает страницу проверки браузера и принимает ее за контент.
WAF, CDN и антибот
Сервисы защиты умеют блокировать неизвестных роботов, показывать им проверку браузера или резать частоту запросов. Робот такую проверку не проходит. Откройте журнал правил защиты и посмотрите, что происходило с запросами, где в User-Agent есть OAI-SearchBot или GPTBot. Бывает, что правило включил хостинг, а владелец о нем не знает.
Отдельный риск связан с JavaScript. В руководстве по JavaScript SEO Google пишет, что выполнять JavaScript умеют не все роботы. Поведение Googlebot нельзя приписывать роботам OpenAI, поэтому как проверить, есть ли текст в исходном HTML, мы разбираем отдельно в статье о том, почему красивый сайт не виден ИИ.
Реальные логи
Прямое свидетельство доступа дает журнал сервера. В нем видны дата, адрес страницы, код ответа, объем ответа, User-Agent и IP. Если визитов OAI-SearchBot нет совсем, это еще не блокировка. Робот мог просто не приходить, и вывод делают только вместе с проверкой правил защиты.
- robots.txt. Файл открывается по адресу /robots.txt с кодом 200, группы для OAI-SearchBot и GPTBot записаны так, как решил владелец.
- Публичные страницы. Отдают 200 и текст без проверки браузера.
- Защита. В журнале WAF нет блокировок для адресов из списков OpenAI.
- Логи. Есть визиты роботов с кодом 200 или понятна причина их отсутствия.
Файл llms.txt к доступу роботов отношения не имеет, его разбор вынесен в статью о том, нужен ли сайту файл llms.txt и как проверить внедрение.
Как безопасно открыть публичный контент
Открыть сайт для OAI-SearchBot не значит открыть все подряд. Робот должен видеть то, что и так видит любой посетитель без входа. Каталог, услуги, цены, статьи, контакты, условия доставки.
robots.txt публичен, его читает кто угодно. Поэтому он плохо подходит для защиты. Строка Disallow с путем к админке сообщает всем, на какой CMS работает сайт и где искать вход. Личные кабинеты, заказы, файлы с данными клиентов и тестовая копия сайта должны быть закрыты паролем или авторизацией на сервере, а не правилом для роботов.
Перед тем как снимать ограничения, пройдитесь по публичным страницам глазами постороннего. На них не должно быть телефонов сотрудников из внутренних списков, ссылок на выгрузки с персональными данными и PDF с договорами клиентов. Если такое нашлось, сначала убирают материал, потом открывают доступ.
Почему подмена User-Agent не доказательство
User-Agent это строка, которую клиент сообщает о себе сам. Любой парсер может назваться OAI-SearchBot, и сервер ему поверит. Отсюда две типичные ошибки.
Первая ошибка в чтении логов. Запись с User-Agent GPTBot еще не значит, что приходила OpenAI. Под известных роботов маскируются сборщики контента, потому что их реже блокируют.
Вторая ошибка в проверке настроек. Запрос из консоли с подставленной строкой OAI-SearchBot показывает, как сервер реагирует на эту строку с вашего IP. Защита может проверять адрес и вести себя с настоящим роботом иначе. Такой тест полезен для поиска очевидных блокировок, но не подтверждает доступ.
Происхождение проверяют по официальным данным. OpenAI публикует диапазоны адресов для каждого робота в файлах searchbot.json, gptbot.json и chatgpt-user.json. Файлы обновляются, у них есть дата создания, поэтому сверяться нужно со свежей копией, а не с адресами, которые разработчик скопировал год назад. Запросы к robots.txt OpenAI может помечать в User-Agent отдельной пометкой, это помогает отличить их в журналах без путей.
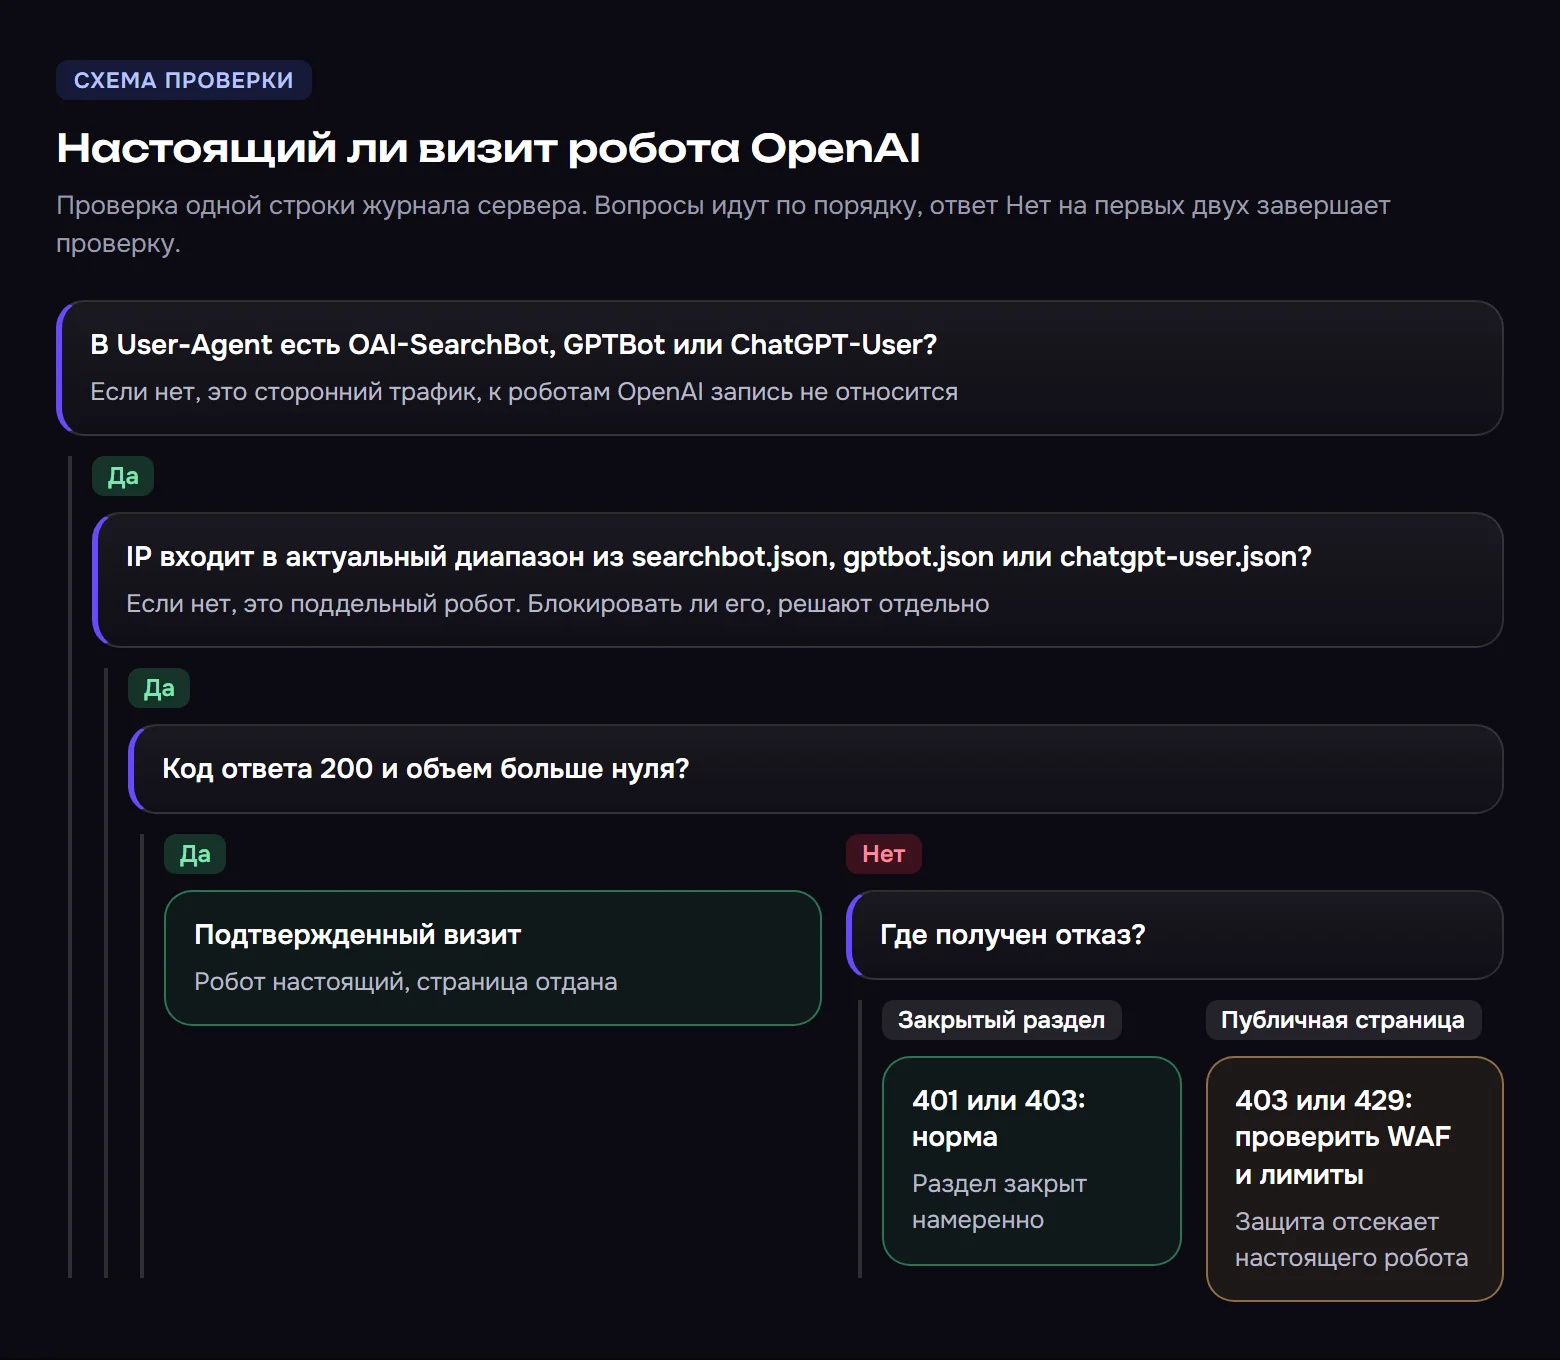
Текстовая версия схемы
- В User-Agent есть OAI-SearchBot, GPTBot или ChatGPT-User?. Если нет, это сторонний трафик, к роботам OpenAI запись не относится
- Да:
- IP входит в актуальный диапазон из searchbot.json, gptbot.json или chatgpt-user.json?. Если нет, это поддельный робот. Блокировать ли его, решают отдельно
- Да:
- Код ответа 200 и объем больше нуля?
- Да:
- Подтвержденный визит. Робот настоящий, страница отдана
- Нет:
- Где получен отказ?
- Закрытый раздел:
- 401 или 403: норма. Раздел закрыт намеренно
- Публичная страница:
- 403 или 429: проверить WAF и лимиты. Защита отсекает настоящего робота
Подтвержденный визит выглядит так. Строка журнала с нужным User-Agent, IP из актуального официального диапазона, код 200 и ненулевой объем ответа. Строку с правильным User-Agent и чужим IP считают обычным сторонним трафиком и решают по ней отдельно, блокировать ли такой парсер.
Проверка с подставленным User-Agent полезна для обнаружения реакции на строку, но не подтверждает запрос настоящего робота. Сопоставляйте ее с журналом сервера и актуальными официальными диапазонами IP.
Отдельно проверьте Search generative AI control: Search Console, Settings -> Search generative AI. Настройка управляет участием ресурса в поддерживаемых генеративных функциях Поиска. Учитывайте наследование от родительского ресурса. Это не управление обучением через Google-Extended и не доказательство того, что настройка конкретного сайта выключена. Открытый доступ и разрешенное участие не гарантируют показ.
Как передать задачу разработчику
Разработчику проще работать с проверяемыми условиями, чем с просьбой открыть сайт для ChatGPT. Хорошая задача описывает решение владельца, конкретные проверки и формат отчета.
- Решение по роботам. OAI-SearchBot разрешен для публичных разделов, по GPTBot указан выбор владельца, закрытые разделы перечислены.
- robots.txt отдает 200 и содержит группы правил в согласованном виде.
- Правила WAF и CDN пропускают адреса из официальных списков OpenAI, списки подтягиваются автоматически.
- Кабинеты, заказы и тестовые копии отдают 401 или 403 всем без авторизации.
- Журнал результата за две-три недели содержит дату, URL, код ответа, User-Agent, IP и отметку, входит ли IP в официальный диапазон.
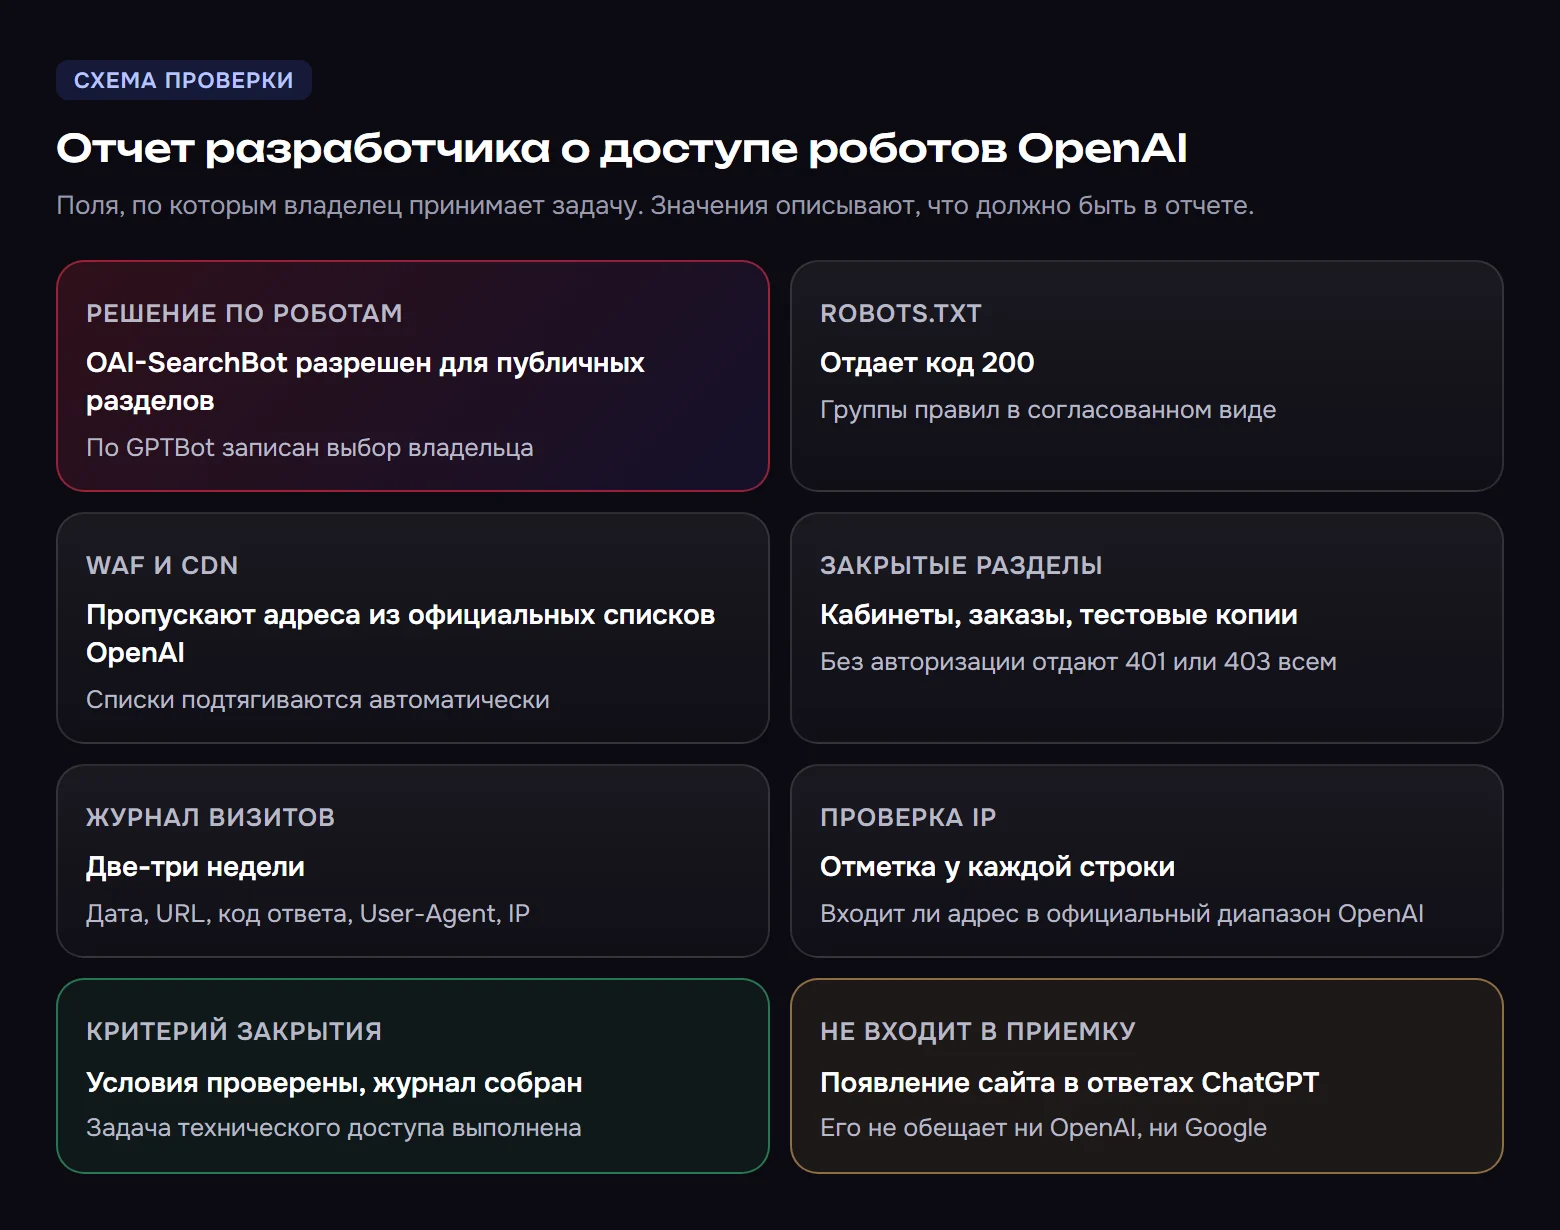
Текстовая версия схемы
- Решение по роботам: OAI-SearchBot разрешен для публичных разделов. По GPTBot записан выбор владельца
- robots.txt: Отдает код 200. Группы правил в согласованном виде
- WAF и CDN: Пропускают адреса из официальных списков OpenAI. Списки подтягиваются автоматически
- Закрытые разделы: Кабинеты, заказы, тестовые копии. Без авторизации отдают 401 или 403 всем
- Журнал визитов: Две-три недели. Дата, URL, код ответа, User-Agent, IP
- Проверка IP: Отметка у каждой строки. Входит ли адрес в официальный диапазон OpenAI
- Критерий закрытия: Условия проверены, журнал собран. Задача технического доступа выполнена
- Не входит в приемку: Появление сайта в ответах ChatGPT. Его не обещает ни OpenAI, ни Google
Задача закрыта, когда условия проверены и журнал собран. Появление сайта в ответах ChatGPT в критерии приемки не входит, его не обещает ни OpenAI, ни Google в своих правилах. Доступ только убирает техническое препятствие.
robots.txt, коды ответа и журнал защиты владелец может проверить сам. Если доступ открыт, а подтвержденных визитов нет, или нужно связать доступ с содержанием страниц и источниками ответов, это задача для SEO и GEO-специалиста, например в рамках услуги продвижение бизнеса в ответах ИИ.
Как проверить правила обхода на своём сайте
Начните с публичного robots.txt и правил хостинга. В сохранённом срезе Q2 от 23 октября 2026 года общая группа разрешает обход и указывает sitemap. Это позволяет проверить опубликованные правила, но не историю визитов.
User-agent: *
Allow: /

Sitemap: https://q2.team/sitemap.xml
Следующий шаг — сопоставить запросы в журнале сервера с официальными диапазонами IP OpenAI. Записывайте отдельно правило доступа, факт подлинного визита и присутствие в ответах: одно не подтверждает другое.
Частые вопросы
Нет. Правила robots.txt задаются для конкретного робота, а Google управляет обходом для поиска, включая AI Overviews и AI Mode, через правила для Googlebot.
Да. В группе правил для OAI-SearchBot можно закрыть отдельные разделы через Disallow и оставить открытыми остальные. Проверьте, что закрытые разделы не нужны покупателю для выбора.
Запросите у поддержки журнал срабатываний защиты и попросите разрешить адреса из официальных списков OpenAI. Разрешение по одной строке User-Agent откроет сайт и для поддельных роботов.
Это решение бизнеса, а не техническая необходимость. Его принимают, если тексты, описания товаров или исследования имеют коммерческую ценность и компания не хочет отдавать их для обучения моделей.
 Александр Кабанец